
llms.txt erklärt: Was die Datei wirklich bringt
Für die meisten Websites bringt eine llms.txt derzeit nichts. Im Mai 2026 bekamen 97 Prozent der untersuchten Dateien keine einzige Anfrage. Die Zugriffe, die es überhaupt gab, stammten überwiegend von SEO-Werkzeugen statt von KI-Assistenten. Lohnend ist die Datei hingegen dort, wo Software und Agenten im Arbeitsalltag Dokumentation nachschlagen.
Angelegt ist sie in zehn Minuten und kostet nichts. Genau das macht die Entscheidung schwer, denn was so wenig kostet, lässt man ungern liegen.
Seit Juni 2026 gibt es darauf eine Antwort mit Zahlen dahinter. Eine Auswertung über 137.210 Domains zeigt, was mit diesen Dateien tatsächlich geschieht, wer sie abruft und wie viele von ihnen in einem ganzen Monat kein einziges Mal geöffnet werden.
Ob die Datei abgerufen wird, warum Google gleichzeitig abrät und darauf prüft und für welche Websites sich der Aufwand rechnet, lässt sich damit belegen statt schätzen.
Das Wichtigste in Kürze:
Was in einer llms.txt steht und wofür sie gedacht war
Eine einzige Überschrift in der llms.txt genügt der Spezifikation. Alles Weitere ist optional, von der Kurzbeschreibung im Zitatblock über einen erklärenden Absatz bis zu den thematisch sortierten Linklisten, die den eigentlichen Nutzen der Datei ausmachen.
Vorgeschlagen hat das Format Jeremy Howard, Mitgründer von Answer.AI, im September 2024. Sein Argument war schlicht: Weil ein Sprachmodell nur ein begrenztes Kontextfenster hat und eine Seite im Auszeichnungsformat des Webs (HTML) mit Navigation, Bannern und Skripten ein Vielfaches des eigentlichen Textes verbraucht, sollte es eine schlanke Fassung derselben Inhalte geben.
Ihre Datei ist reines Markdown und liegt unter ihre-domain.de/llms.txt. Sie sperrt niemanden aus. Sie ordnet nichts an. Ein System, das ihr folgt, spart Rechenaufwand. Eines, das sie übergeht, verliert nichts.
Die vier Bestandteile der Datei
Die Datei besteht aus vier Teilen, von denen nur der erste verpflichtend ist:
Auf den erklärenden Halbsatz kommt es an. Er sagt einem System, wofür die Seite gut ist. Ohne ihn bleibt die Datei eine Adressliste ohne Gewicht.
Die vollständige Spezifikation steht auf llmstxt.org und passt auf zwei Bildschirmseiten.
llms.txt, robots.txt und sitemap.xml haben drei verschiedene Aufgaben
Die drei Dateien werden oft in einem Atemzug genannt und leisten Unterschiedliches. Die robots.txt verbietet. Die sitemap.xml listet auf. Die llms.txt empfiehlt, mehr nicht.
| Datei | Aufgabe | Verbindlichkeit | Etabliert seit |
|---|---|---|---|
| robots.txt | regelt, welche Bereiche ein Crawler betreten darf | Standard, von allen seriösen Crawlern beachtet | 1994 |
| sitemap.xml | listet alle indexierbaren URLs vollständig auf | Standard, von Suchmaschinen ausgewertet | 2005 |
| llms.txt | empfiehlt eine kuratierte Auswahl an Inhalten | Vorschlag ohne Zusage eines Anbieters | 2024 |
Der Unterschied, der alles entscheidet
Ein Unterschied wiegt schwerer als alle anderen. Weil jeder seriöse Crawler die robots.txt vor dem ersten Seitenabruf holt und weil die sitemap.xml Ihre Website aktiv bei der Suchmaschine anmeldet, kommen beide Dateien von allein an ihr Ziel. Für die llms.txt existiert kein solcher Automatismus.
Was die Datei ausdrücklich nicht ersetzt
Die llms.txt steuert keinen Zugriff. Wollen Sie einen KI-Crawler aussperren, gehört die Regel in Ihre robots.txt.
Sie ersetzt auch die Sitemap nicht, denn eine Suchmaschine erwartet dort alle indexierbaren Adressen, während die llms.txt bewusst nur eine Auswahl führt. Beides in eine Datei zu pressen, kostet den Vorteil beider.
Strukturierte Daten ersetzt sie ebenfalls nicht. Auszeichnungen nach schema.org beschreiben einzelne Entitäten maschinenlesbar auf der Seite selbst. Darauf greifen Suchmaschinen wie KI-Systeme nachweislich zu.
97 Prozent der Dateien bekommen keine einzige Anfrage
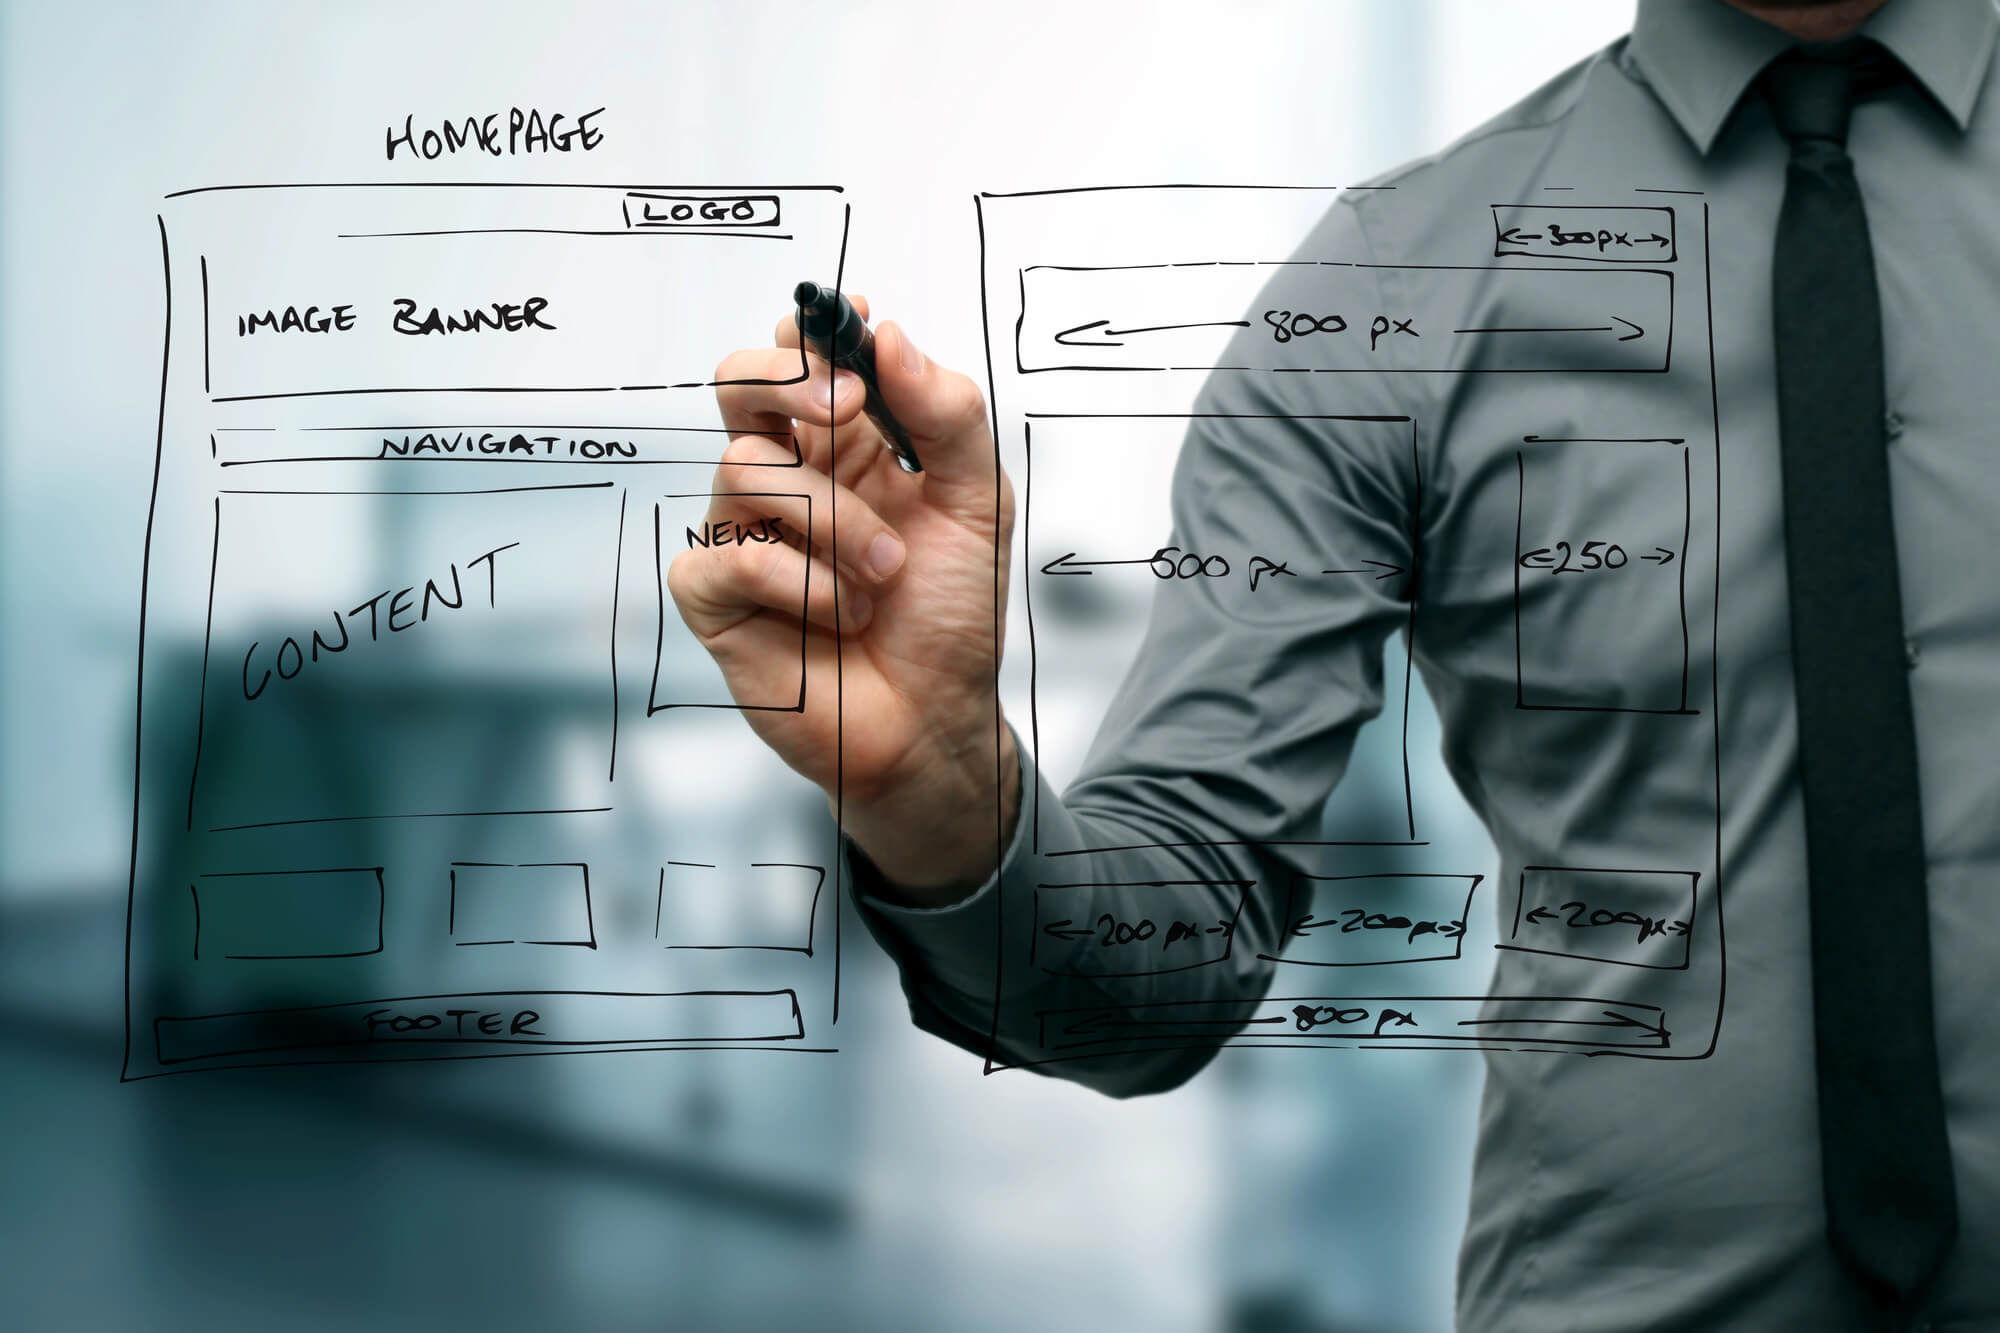
Im Mai 2026 blieben 97 Prozent aller untersuchten llms.txt-Dateien unangetastet. Von 38.360 Domains mit einer solchen Datei verzeichneten nur rund 1.100 überhaupt Zugriffe.
Die Zahl stammt aus einer Auswertung von Ahrefs über 137.210 Domains, veröffentlicht am 15. Juni 2026. 28 Prozent dieser Domains hatten eine llms.txt angelegt.
Die Studie zählt nicht allein, wer eine Datei anlegt. Sie wertet zusätzlich die Serverprotokolle aus, weshalb sich zum ersten Mal beziffern lässt, wer diese Dateien öffnet. Von den Anfragen stammten 96 Prozent von Bots und 4 Prozent von Menschen.
Die Abrufer sind überwiegend SEO-Werkzeuge
77 Prozent der abrufenden Bots sind keine KI-Werkzeuge. Die größte einzelne Gruppe bilden SEO-Audit-Tools mit 21,7 Prozent, gefolgt von allgemeinen Crawlern und Monitoring-Diensten.
KI-Bots kommen zusammen auf 19,5 Prozent, wovon 10,5 Prozentpunkte auf Agenten entfallen, 5,3 auf Trainingscrawler und 2,5 auf Assistenten.
Für Ihre Sichtbarkeit in KI-Antworten zählt davon nur eine Gruppe: die Retrieval-Bots, die während einer laufenden Anfrage Quellen nachladen. Sie machen 1,1 Prozent der Zugriffe aus.
Auch dieser Rest schrumpft noch
Rechnet man die Werkzeuge heraus, die eine llms.txt gezielt untersuchen, weil ihre Nutzer wissen wollen, ob es sie gibt, schrumpft der Rest weiter. Allein 12 Prozent der Abrufe gehen auf solche Prüfwerkzeuge zurück.
KI-Systeme suchen nicht von selbst nach der Datei
Ahrefs prüfte auch Domains ohne llms.txt. Dort kam keine einzige Anfrage eines KI-Bots an, die ins Leere gelaufen wäre. Daraus folgt der wichtigste Befund der ganzen Auswertung. Kein System klopft die Adresse routinemäßig ab.
Für die Praxis heißt das, was in den meisten Anleitungen fehlt. Eine Datei, auf die nichts verweist, findet niemand. Agenten folgen Verweisen. Geraten wird nichts.
Warum die beiden anderen Dateien ankommen
Bei robots.txt und sitemap.xml ist das anders geregelt, denn die eine Adresse gehört zum Protokoll und die andere meldet Ihr System selbsttätig an die Suchmaschine. Für die llms.txt gibt es nichts Vergleichbares.
Legen Sie die Datei an, verweisen Sie auch darauf. Drei Stellen genügen:
Ohne diesen Schritt ist die Arbeit verloren und daran scheitern die meisten Umsetzungen.
Google rät von der Datei ab und prüft trotzdem darauf
Ende Mai 2026 ergänzte Google seine Suchdokumentation um einen Abschnitt zum Aufräumen mit Mythen. Darin heißt es, dass für die generative KI-Suche keine besonderen Dateien nötig sind und maßgeblich der Inhalt der Seiten selbst bleibt.
Wenige Tage später lieferte das Chrome-Team ein Lighthouse-Audit aus, das prüft, ob eine Website eine llms.txt bereitstellt. Zwei Häuser desselben Konzerns, zwei Botschaften.
Praktische Folgen hatte der Prüfpunkt kaum. Er löste in der Ahrefs-Auswertung 22 Abrufe aus, also etwa einen von tausend.
Was Google selbst dazu sagt
John Mueller von Google ordnete das Format im Juni 2026 als vorübergehende Krücke ein, die KI-Werkzeugen beim Programmieren Rechenaufwand spart. Bereits 2025 hatte er es öffentlich mit dem Keyword-Meta-Tag verglichen. Suchmaschinen ignorieren dieses Tag seit vielen Jahren.
Für das Ranking in der Google-Suche hat die Datei damit keine belegte Wirkung. Wird sie Ihnen so angeboten, fragen Sie nach.
Wie sich Suchmaschinenoptimierung und KI-Sichtbarkeit zueinander verhalten, ordnet unser Beitrag zu SEO und GEO ein.
Für diese Websites rechnet sich eine llms.txt
Am deutlichsten zahlt sich die Datei bei vier Arten von Websites aus:
Nachrangig bleibt sie für lokale Dienstleister, Onlineshops und Websites mit wenigen Unterseiten. Für einen Handwerksbetrieb mit vierzehn Seiten entsteht kein Nutzen, der die laufende Pflege trägt.
Die Zahlen sprechen nicht gegen die Datei. Sie verschieben ihren Zweck. Abgerufen wird sie überwiegend von Agenten und Programmierwerkzeugen, also von Software, die während der Arbeit gezielt Dokumentation nachschlägt und dabei jedes gesparte Token in bare Rechenzeit umsetzt.
Eine Ausnahme, die es wirklich gibt
Eine Ausnahme kommt vor. Verkaufen Sie erklärungsbedürftige Technik und schreibt Ihre Zielgruppe im Arbeitsalltag mit KI-Assistenten, kann sich die Datei auch bei kleiner Seitenzahl lohnen. Das lässt sich vorab nicht sagen, das zeigt erst Ihr Serverprotokoll.
Über Ihre Sichtbarkeit in KI-Antworten entscheidet dort etwas anderes, nämlich die Inhalte selbst, die belegten Fakten darin und die Frage, ob Ihre Marke außerhalb der eigenen Website überhaupt vorkommt.
Dafür gibt es Generative Engine Optimization. Die Grundlagen dazu stehen in unserem Beitrag: Was ist GEO.
Version 2 der Spezifikation ändert seit August 2026 drei Dinge
Am 10. August 2026 wurde die Spezifikation überarbeitet. Die Neuerungen sind wenige Tage alt. In den gängigen Anleitungen stehen sie noch nicht.
Was das für die Praxis bedeutet
Der dritte Punkt beantwortet genau die Schwäche aus dem vorigen Abschnitt, denn ohne einen maschinenlesbaren Verweis findet kein Agent die Datei.
Ob sich das in den Abrufzahlen niederschlägt, lässt sich heute nicht sagen. Die jüngste Erhebung stammt aus dem Juni 2026 und damit aus der Zeit vor der Änderung.
So legen Sie eine llms.txt an
Sie brauchen einen Texteditor und Schreibzugriff auf das Wurzelverzeichnis Ihrer Website. Mehr an Technik ist nicht nötig.
- Wählen Sie die 10 bis 30 Seiten aus, die Ihr Angebot fachlich tragen.
- Legen Sie die Datei an: eine H1 mit dem Namen, darunter ein Zitatblock mit einem Satz zum Angebot.
- Gruppieren Sie die Links nach Themen, je Eintrag Name, URL und ein erklärender Halbsatz.
- Schieben Sie Nachrangiges in den Abschnitt „Optional“.
- Laden Sie die Datei als llms.txt ins Wurzelverzeichnis, erreichbar unter ihre-domain.de/llms.txt.
- Verweisen Sie darauf: link-Element im Quelltext, Fußzeile, Dokumentation.
Warum ein Generator die Arbeit nicht abnimmt
Generatoren nehmen Ihnen den ersten Schritt nicht ab. Sie exportieren meist die komplette Sitemap. Heraus kommt eine ungewichtete Liste aller URLs, also das Gegenteil dessen, wofür die Datei gedacht ist.
Planen Sie die Pflege gleich mit ein, denn eine veraltete Datei schadet mehr als eine fehlende, weil ein System, das ihr folgt, auf gelöschten Seiten landet und diesen Fehlschlag Ihrer Domain zurechnet.
llms.txt oder llms-full.txt
Als Inhaltsverzeichnis bleibt die llms.txt bei ein bis drei Kilobyte. Die llms-full.txt enthält dagegen den gesamten Text einer Website in einem einzigen Dokument und erreicht schnell mehrere hundert Kilobyte.
In der Spezifikation ist die Vollfassung nicht normiert. Sie hat sich in der Praxis etabliert, überwiegend bei technischen Dokumentationen, bedeutet für die meisten Websites aber doppelte Pflege ohne belegten Zusatznutzen.
Woran Sie erkennen, ob Ihre llms.txt gelesen wird
Das Access-Log Ihres Webservers beantwortet die Frage in zwei Minuten. Filtern Sie es auf Aufrufe von /llms.txt und sehen Sie sich an, welche Systeme dort auftauchen. Bei den meisten Hostern liegt dafür eine fertige Auswertung im Kundenmenü bereit, sodass Sie nicht einmal eine Protokolldatei herunterladen müssen.
Die Search Console hilft hier nicht weiter. Sie bildet ab, was in der Google-Suche geschieht. Um die Google-Suche geht es bei der llms.txt gerade nicht.
Diese Namen sollten Sie unterscheiden
Trainingscrawler wie GPTBot, ClaudeBot oder CCBot sammeln Inhalte für spätere Modellversionen, weshalb ein Treffer von ihnen nichts darüber aussagt, ob Ihre Marke morgen in einer Antwort auftaucht.
Retrieval-Bots wie ChatGPT-User oder PerplexityBot laden Quellen nach, während eine Antwort für einen echten Nutzer entsteht. Diese Zeilen im Protokoll sind die einzigen, die unmittelbar auf Sichtbarkeit einzahlen.
Rechnen Sie damit, dass Sie gar nichts finden. In der Ahrefs-Auswertung traf das auf 97 Prozent der Domains mit einer llms.txt zu. Ein leeres Protokoll ist der Normalfall.
Erst wenn dort über mehrere Wochen regelmäßig Retrieval-Bots auftauchen, lohnt der Ausbau. Bis dahin bleibt die Datei eine Wette.
Ein Risiko, das in den Anleitungen fehlt
Die llms.txt ist Text, den Sie einem System vorlegen, das Text als Anweisung verstehen kann. Das macht sie angreifbar.
Gelangt jemand an Schreibrechte für Ihr Wurzelverzeichnis, kann er dort Anweisungen hinterlegen, die ein Agent liest und befolgt. Belegte Vorfälle dieser Art liegen bisher nicht vor.
Weil die Datei aber ausdrücklich für maschinelle Leser geschrieben ist und weil ihr Inhalt in einem Arbeitsschritt landen kann, den niemand mehr kontrolliert, gehört sie in dieselbe Rechteverwaltung wie robots.txt und Sitemap.
Der zweite Punkt ist unspektakulärer. Eine llms.txt macht die Struktur Ihrer Inhalte für jeden maschinenlesbar, der sie abruft. Einem Wettbewerber, der Ihre Themenabdeckung analysiert, sparen Sie damit Arbeit.
Beides spricht die Datei nicht ab. Es verlangt nur, sie wie jede andere Serverdatei zu behandeln.
Warum netzbekannt.de bisher keine llms.txt hat
Ein Aufruf von netzbekannt.de/llms.txt läuft ins Leere, geprüft am 13. August 2026. Das folgt aus den Zahlen weiter oben und aus der Frage, für wen wir arbeiten.
Die Netzbekannt GmbH betreut überwiegend lokale Dienstleister, also Handwerksbetriebe, Praxen, Kanzleien und z. B. Reinigungsdienste. Für dieses Umfeld liegt uns kein Beleg dafür vor, dass die Datei nennenswert abgerufen wird.
Was wir stattdessen in jedem Projekt prüfen
Das klingt weniger nach Neuheit. Wir prüfen in jedem Projekt zuerst, ob KI-Crawler überhaupt Zugriff auf die Website haben.
Eine robots.txt, die GPTBot, ClaudeBot oder PerplexityBot aussperrt, kostet Sichtbarkeit sofort und daran ändert keine Zusatzdatei etwas. Ob Ihre Domain betroffen ist, zeigt die kostenlose KI-Analyse in wenigen Minuten.
Sobald die Abrufzahlen ein anderes Bild zeigen, ändern wir die Empfehlung und schreiben es an dieser Stelle. Bis dahin fließt der Aufwand in Ihre Inhalte. Das wirkt messbar.
GASTBEITRAG BEI AGENTURTIPP
GEO-Optimierung 2026: Worauf es jetzt ankommt
Netzbekannt wurde zum wiederholten Male bei Agenturtipp als Agentursieger ausgezeichnet. In unserem Gastbeitrag dort erläutert unser Geschäftsführer Gabriel Gelman, worauf es beim Thema GEO jetzt ankommt: Jetzt bei Agenturtipp lesen


